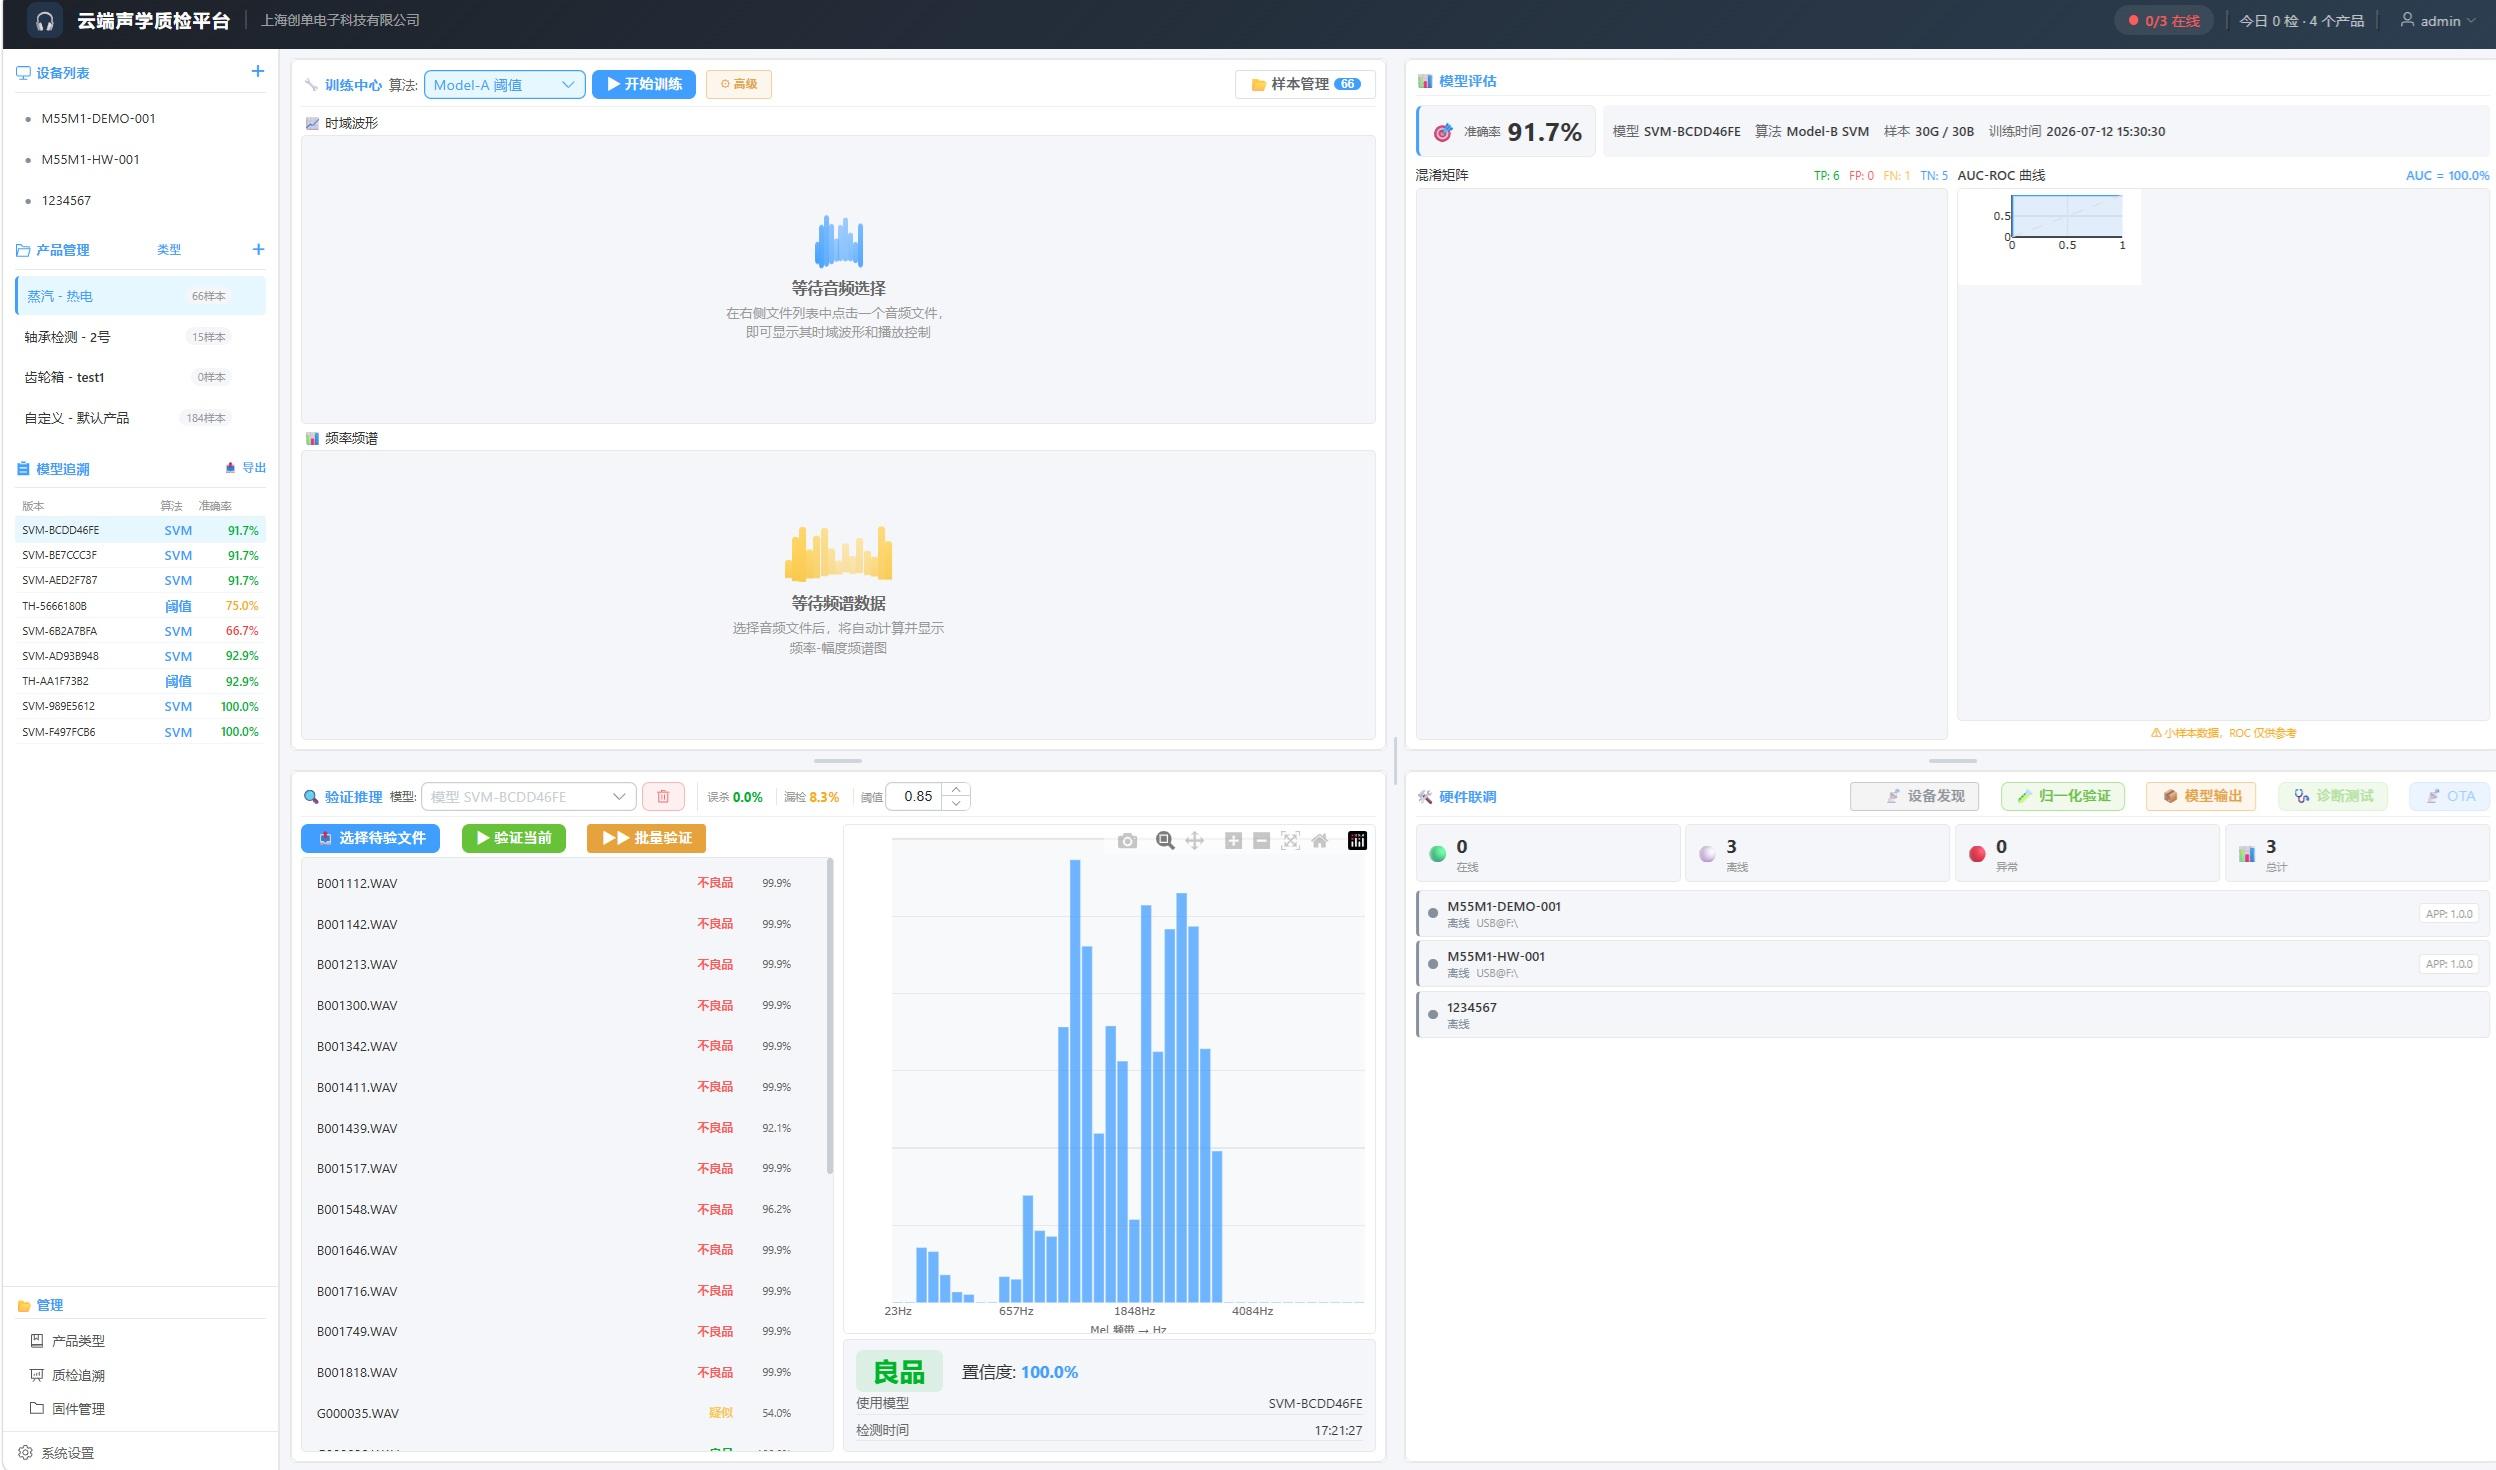
跨平台特征对齐的问题解决之后,会立刻撞上第二道门槛:
技术能跑通了,但会用的人不对。
算法工程师能搞定 CMSIS-DSP、能调 MFCC 参数、能写 C 代码把模型塞进 MCU。但工厂里最终要操作这套系统的人,是质检员 —— 他可能没写过一行 Python,也不关心什么是梅尔频率倒谱系数。
他关心的是:把「好声音」和「坏声音」放进去,出来一个能直接在产线上用的模型。
从「技术可用」到「一线人员可用」,中间隔着一道工程化封装的鸿沟。 这道鸿沟如果不填,前面所有的算法工作都无法转化为产线价值。
01 传统工作流在哪里断掉
一个典型的 AI 声学检测项目,传统工作流大致是这几步:
写 Python 脚本,通过声卡或采集卡录制样本
用 Audacity 之类的工具手动切分、标注波形
写训练脚本,提取特征、训练模型
导出模型权重,自己写 C 推理代码
自己实现 PLC 通信协议(Modbus 等),对接产线
这条链路上有四个断点,每一个都会劝退非算法背景的工程师:
环节 传统做法 断点在哪
采集 写 Python 脚本控制声卡 需要编程,且采集条件难统一
标注 用音频软件手动切分 效率低,无法与频谱对照
训练 写脚本调参 需要算法背景,参数选择靠经验
部署 手写 C 代码 + 通信协议 需要嵌入式能力,产线对接是黑盒
四个断点叠加的结果是:项目必须依赖算法工程师全程参与,周期动辄 2–4 周,成本几十万起步。
这个门槛直接把大量中小制造企业挡在了门外。
02 图形化封装的四个改造点
封装的目标不是「把命令行换成按钮」,而是把隐性知识固化进系统,让使用者不需要知道原理也能得到正确结果。
具体是四个改造:
改造一:采集环节 —— 从写脚本到一键录制
硬件连接后,平台直接接管采集。触发方式、采样率、增益这些参数由系统预设,使用者只需要点击录制。
更重要的是:采集条件被固化了。同一台设备、同一个工装位置、同一套参数 —— 这保证了训练集和后续推理集的采集条件一致,从源头避免了数据分布漂移。
改造二:标注环节 —— 从手动切分到时域 + 频域双视图
传统做法是在波形图(时域)上切分,但很多异音特征在时域上看不出来,要在频谱图(频域)上才明显。
双视图标注的做法是:界面同时显示波形图和语谱图,使用者用鼠标框选即可完成标注。框选区域在两幅图上同步高亮。
这样使用者不需要理解 MFCC 是什么 —— 他只要在频谱图上框出「听起来正常的那一段」,系统自动完成后续的特征提取。
改造三:训练环节 —— 从写脚本到参数自动推荐
声学特征提取里有大量「只可意会」的经验参数:Mel 滤波器用多少维?DCT 系数取前几位?窗长和帧移怎么配合?
这些参数在传统方案里靠算法工程师的经验调试。在封装后的平台里,这些经验被固化在默认参数和自动推荐逻辑中。
使用者不需要知道为什么这么设,但能得到正确的结果。
改造四:部署环节 —— 从手写代码到自动生成工程
这是最能压缩周期的一步。
模型训练完成后,平台自动生成完整的工程代码,包含:
模型调用与推理逻辑
预处理(基于 CMSIS-DSP 优化的实现)
工业通信协议(Modbus 等)的对接代码
模型参数通过 USB 或网络一键同步到硬件。初级技术人员不需要编写任何 C 代码或 Python 代码。
03 关键的架构选择:硬件必须能脱离平台独立运行
这里有一个容易被忽视但极其重要的设计决策:
模型同步到硬件后,硬件应当完全独立运行,不再依赖平台或服务器。
为什么这一点关键?三个原因:
数据主权:工业客户普遍不接受产线数据上传云端。本地推理意味着声音数据不出车间。
网络条件:许多车间网络受限甚至物理隔离,依赖云端的方案根本无法部署。
可靠性:网络抖动或服务器故障不应导致产线停机。
具体的性能参数(以 ARM Cortex-M55 级别平台为例):
音频推理:≤10ms
NPU 分类推理:≤100ms
运行方式:纯本地,不联网、不上云
配合固定式硬件架构保证采集条件的一致性,整条链路从「采集 → 标注 → 训练 → 部署 → 独立推理」形成完整闭环。
04 效果与边界
经过封装后,一个完全没有声学背景的质检工程师,在平台上完成标注和训练,3 天内可以在真实产线上搭建起一套声学检测系统。
但必须说清楚这套方案的边界,避免过度承诺:
适用场景
有明确良品样本、缺陷表现为「偏离正常」的产线
缺陷与声音强相关(异音、卡滞、松动、装配异常)
产线节拍允许 ≤5 秒/件的检测时间
不适用场景
完全无振动、无声音输出的零部件缺陷
现场背景噪声与缺陷异音频谱高度重合(需在立项前做可行性测试)
需要在毫秒级完成检测的超高速产线
对使用者的要求
需要理解产品质量标准(能判断什么是良品)
不需要编程能力,但需要接受 1–2 天的平台操作培训
结语
工业 AI 的落地瓶颈,很多时候不在算法,而在能力的可传递性。
一个需要算法工程师全程驻场才能运转的方案,无论精度多高,都很难规模化。反过来,把专家经验封装进工具、让一线人员能独立使用,技术才真正产生了杠杆。
这也是从「卖定制化项目」转向「提供工具平台」的底层逻辑 —— 前者卖的是人力,后者卖的是可复制的能力。
作者:贺中义
单位:上海创单电子科技有限公司(ISSAUTO)
职务:研发总监
本文基于工业级 AI 声学检查平台的工程实践整理