——良品基线学习(One-Class Learning)在工业声学中的落地实践
一条年产百万台的消费电子产线,NPI(新产品导入)阶段要做密封性检测。质量经理想上 AI 声学检测,算法团队提了第一个需求:请提供不少于 500 条不良品声音样本。
三个月后,只凑齐了 7 条。
这不是个例。在工业声学检测领域,「先给我大量标注数据」这个来自消费互联网的经验,几乎是失效的。
01 现实困境:工业声学 AI 的「数据悖论」
真实产线的数据分布,和实验室假设的完全不同:
不良率极低:成熟产线不良率通常在 0.1%–2% 之间。日产万台的工厂,每天产生的不良品数量极其有限。
样本极易流失:下线不良品通常被立即返修或报废,专门拦截并录音的管理成本很高。
缺陷高度集中:产线异常往往集中在某一两类特定缺陷,模型很难学到「所有异常」的通用特征。
新产品导入期零样本:新产线爬坡阶段往往一个不良品都没有,但恰恰是这个阶段最需要建立质检防线。
由此得出的工程结论很直接:在工业声学检测中,「收集大量多样化不良样本」这一传统监督学习的前提条件,在绝大多数场景下不成立。
如果方案的前提是工厂先攒半年不良品,那这个方案在立项阶段就已经被否掉了。
02 范式转换:从「区分猫狗」到「认识猫」
传统监督学习的逻辑是「区分」:给模型看 1000 张猫和 1000 张狗,让它学会分类边界。
良品基线学习(One-Class Learning)的逻辑是「认知」:只给模型看大量猫的照片,让它充分学会「猫长什么样」。此后,凡是偏离这一特征模式的,统统判定为异常。
这个转换在工程上意义重大 —— 它把「需要缺陷样本」变成了「只需要正常样本」,而后者的获取成本几乎为零。
工业场景中常用的无监督 / 单类算法范式有四类,各自适配不同条件:
算法类型 核心思想 适用场景
One-Class SVM 在高维特征空间构建正常样本的边界超球面 特征维度适中,样本量极少(30–200 条)
孤立森林 通过随机分割特征空间,异常点更易被孤立 样本量较大,高维特征空间
自编码器 训练网络重建正常声音,异常声音重建误差大 复杂声学模式,需深层特征表达
GMM 用多个高斯分布拟合正常声音的特征分布 声音模式呈多模态(如多转速工况)
工程首选通常是 One-Class SVM,原因有三:
样本需求低:最低 30 条即可建模,推荐 50 条以建立稳健基线。
计算开销小:可部署于 ARM Cortex-M55 级别的 MCU,无需 GPU。
特征适配性好:对 MFCC 等声学特征的适配性已在大量工业场景中得到验证。
03 三个真实产线的验证
理论之外,更值得看的是落地结果。以下是三条不同行业产线的实际数据:
消费电子:TWS 耳机密封检测
数据条件是 NPI 阶段、零不良品样本。采用良品基线学习,采集良品样本后 2 天完成上线。首月成功拦截 3 起密封不良,过检率(误报率)1.2%。
这是最典型的场景 —— 新产品没有任何不良数据积累,但质检防线必须在量产第一天就位。
汽车零部件:座椅电机异响
产线不良率 0.3%,月均不良品不足 10 台。先用良品基线学习上线覆盖基本需求,运行 3 个月后累计收集到 30 台不良品样本,平滑切换为有监督学习。漏检率从 0.5% 下降至 0.1% 以下。
这个案例的价值在于验证了渐进策略的可行性:不要求一步到位,先上线再优化。
电力设备:变压器异常音监测
缺陷样本极难获取(需停电拆解),几乎不可能建立有监督数据集。采用纯良品基线学习持续运行 6 个月,成功预警 2 起铁芯松动早期故障。
电力场景的特点是故障率低但后果严重,基线学习恰好匹配这种「宁可多报、不可漏报」的需求。
04 五步建模流程
良品基线学习的工程落地可以简化为标准化流程:
第 1 步 · 采集良品样本
通过声学采集设备采集确认良品的声音。平台侧通常内置智能推荐算法,自动剔除低质量录音。
注意:若产品存在多转速、多工况,需分别采集,否则单一基线无法覆盖多个特征簇(此时 GMM 比 One-Class SVM 更合适)。
第 2 步 · 标注「正常」
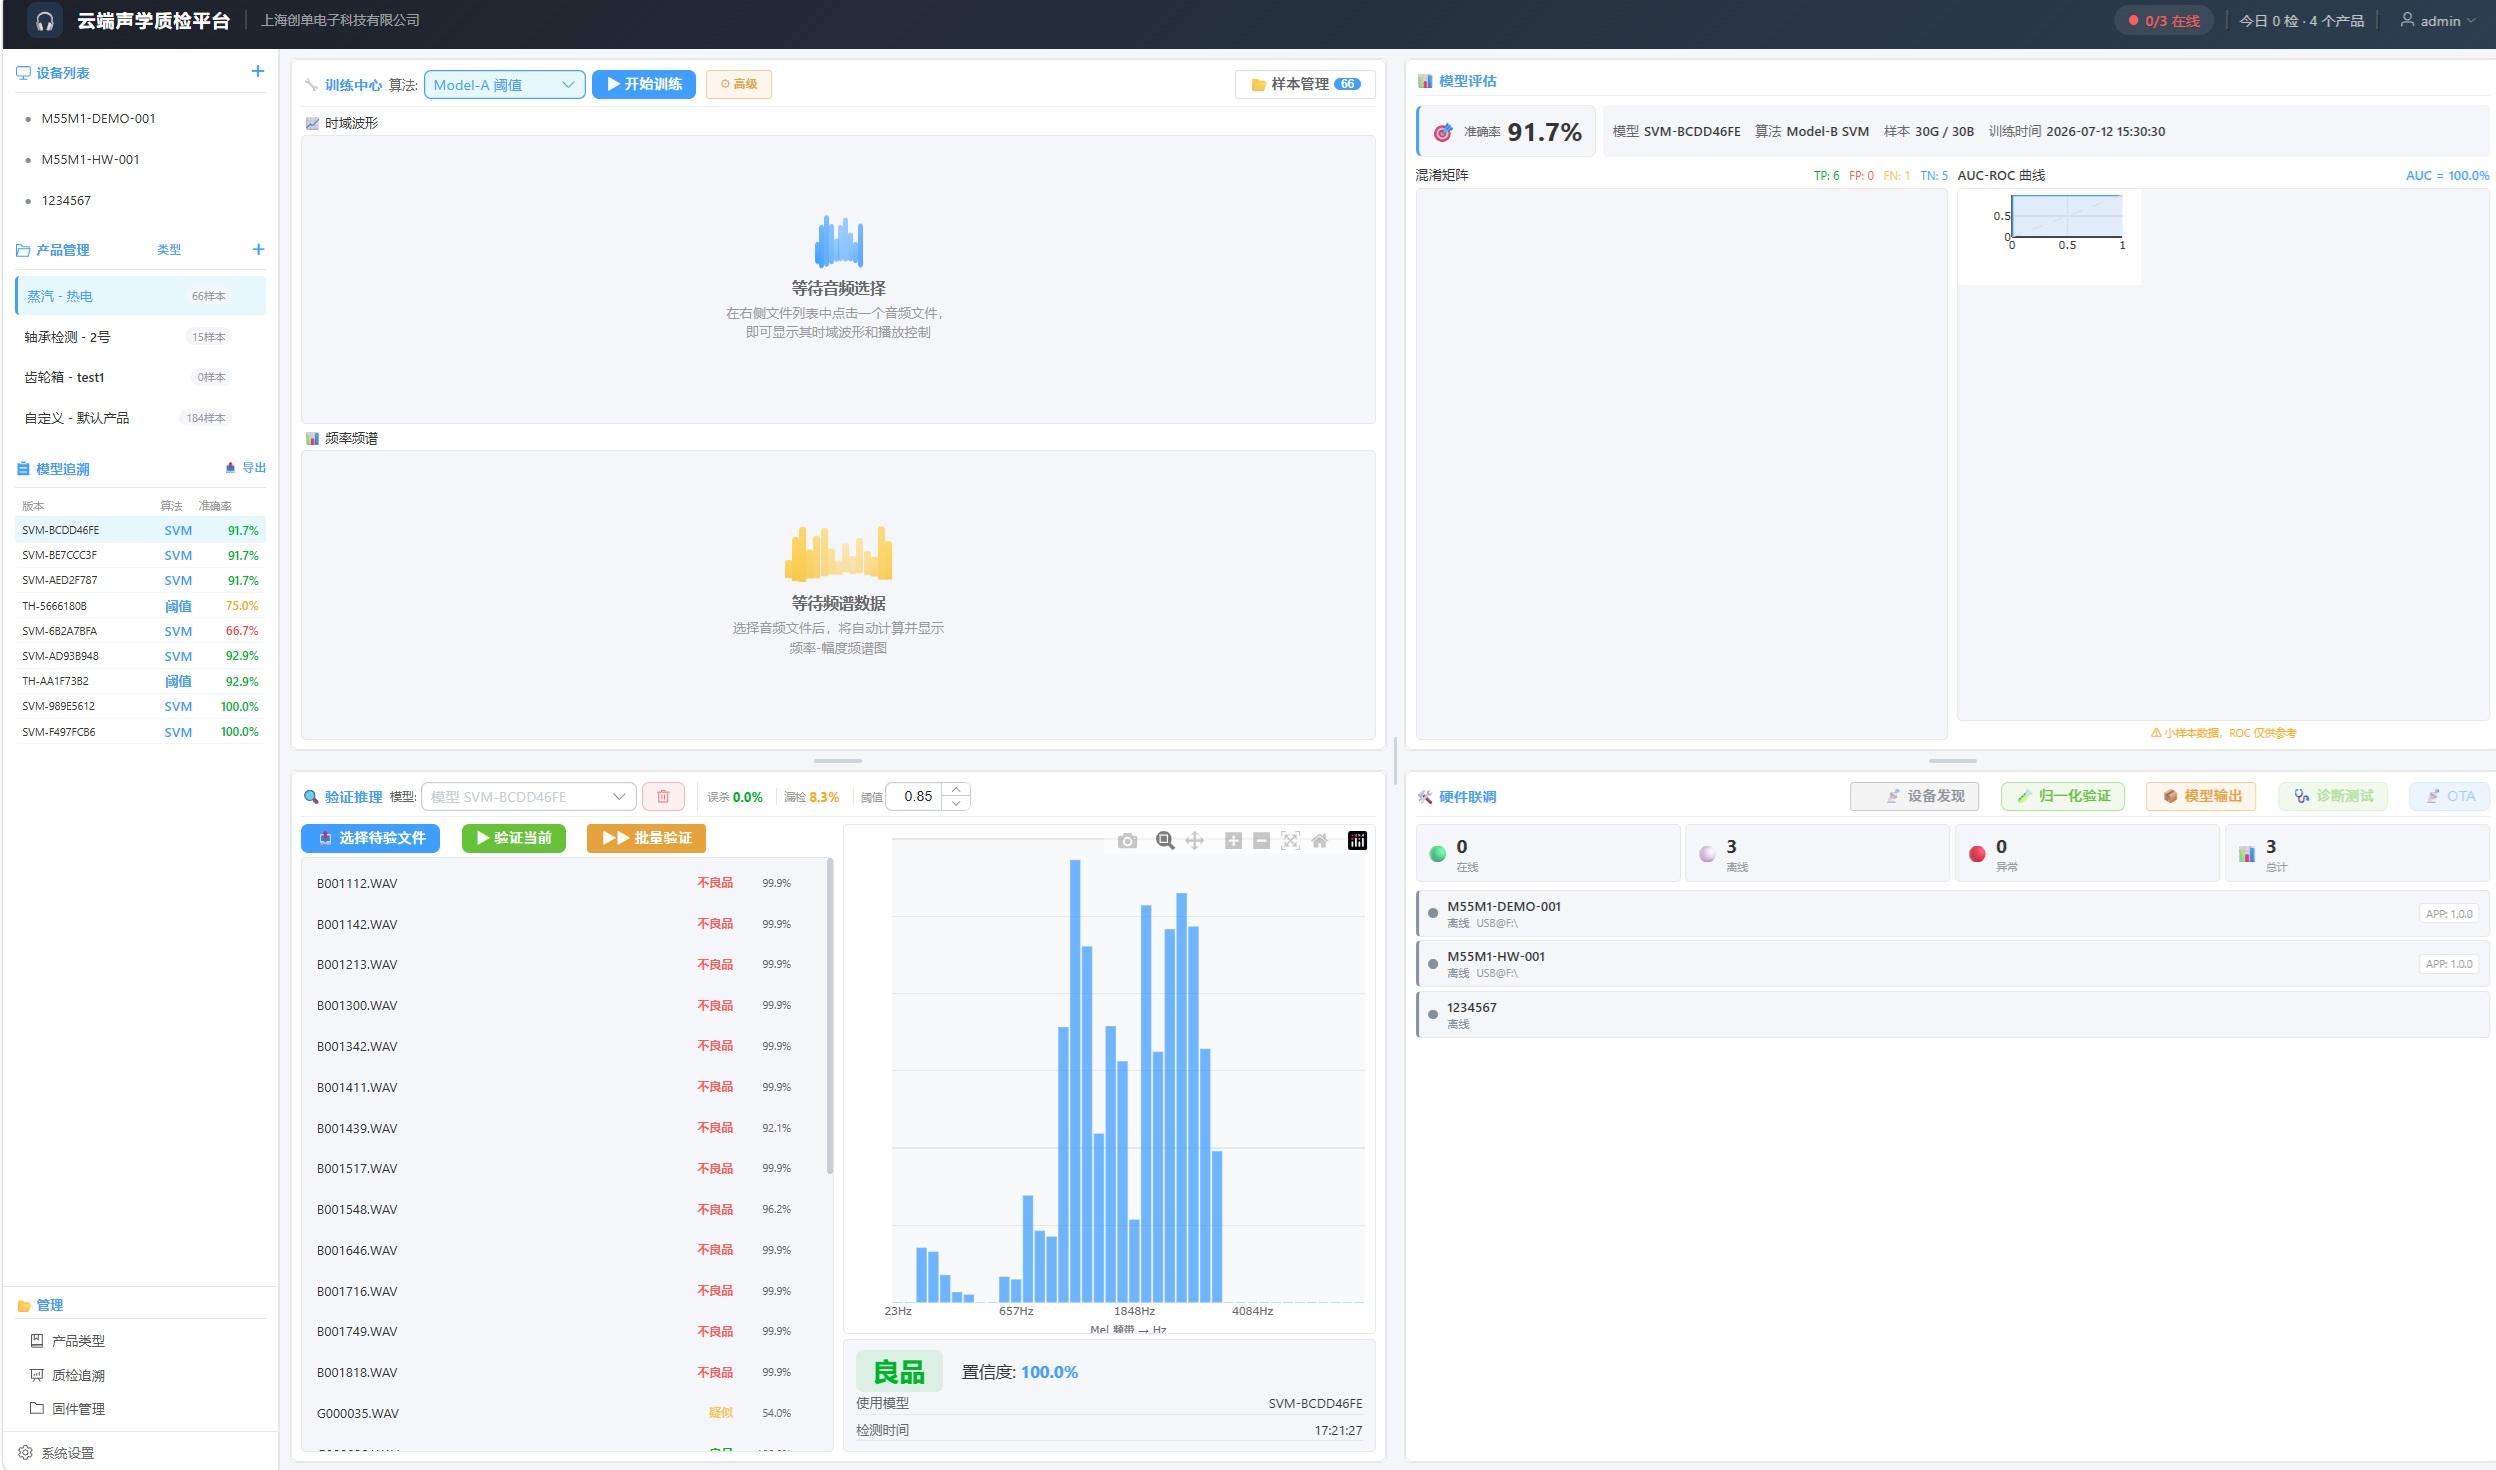
在时域 + 频域双视图界面,将样本统一标记为 Normal。不需要任何异常标签。
第 3 步 · 选择基线学习模式
调用 One-Class SVM 算法,默认参数通常已针对工业场景做过调优。
第 4 步 · 自动化训练
自动完成 MFCC 特征提取、归一化、模型训练及边界优化,耗时通常在数分钟量级。
关键点:提取算法必须与硬件推理端逐维对齐。若训练端(Python/浮点)与推理端(C/定点)的特征提取链路存在偏差,模型部署后精度会明显下降。这是另一个独立的技术议题,此处不展开。
第 5 步 · 工厂模式验证
导入真实产线音频,可视化查看降噪效果、特征分布及异常得分(Anomaly Score),辅助工程师设定阈值。
05 三个高频工程问题
Q1:无监督模型的阈值怎么定?
One-Class SVM 输出的是异常得分(Anomaly Score),不是概率,因此阈值的设定方式直接影响误报与漏报的平衡。
通常提供两种模式:
自动阈值:基于训练集分布自动计算,适合冷启动。
手动阈值:基于已积累的异常样本微调,适合精细化管控。
建议做法是:初期用自动阈值上线,运行 1–2 周后通过人工复核形成闭环,再手动微调至最佳状态。
Q2:设备老化或换型导致基线漂移怎么办?
基线必须支持动态演化。当产线换型、设备大修或环境噪声发生显著变化时,应支持增量训练 —— 在原有基线上加入新良品样本快速更新,无需从头训练,更新周期可压缩至 1 个工作日。
Q3:良品基线学习和有监督学习怎么选?
两者的取舍很清楚:
良品基线学习 有监督学习
样本需求 零不良样本 每类缺陷 ≥20 条
上线周期 2–3 天 较长,取决于样本积累
检出能力 能检出所有「偏离正常」的异常 能精确区分缺陷类型
误报率 相对较高 较低
最佳实践是「先无监督,后监督」的渐进策略:先用基线学习快速上线覆盖基本需求,随着不良品样本积累,逐步引入有监督学习或混合模式,实现精度与召回率的持续优化。
座椅电机那个案例就是这条路径的完整验证。
06 边缘部署:模型最终要在产线上跑
工业 AI 的价值要在边缘端兑现,因此从训练到推理必须是端到端闭环:
一键下发:模型参数通过 USB 或网络写入工作站 Flash。
特征对齐:工作站内置经 DSP 优化的 MFCC 提取算法,与平台训练端逐维对齐,消除跨端精度损失。
本地推理:音频采集 → MFCC 提取 → 异常得分计算 → 阈值比对 → 输出 Pass/Fail。全程通常 ≤100ms,纯本地运行,无需联网。
最后一点对制造业尤其重要:数据不出车间。在网络受限或数据敏感的环境下,工作站仍能作为独立的质检单元运行。
结语
良品基线学习不是万能解法,但它深刻体现了工业 AI 与消费互联网 AI 的分野:承认工厂不是实验室,数据永远不完美。
真正可用的工业 AI 方案,不应该要求企业「先给我 10 万条数据」,而应当具备在「仅有 30 条良品」的极端条件下,于 2–3 天内交付可用检测系统的能力。
不追求理想条件下的精度指标,只交付能在真实产线上跑通的结果 —— 这大概是工业 AI 落地最重要的一条原则。
作者:贺中义
单位:上海创单电子科技有限公司(ISSAUTO)
职务:研发总监
本文技术内容基于工业级 AI 声学检查平台的工程实践整理,案例数据来自实际产线项目。